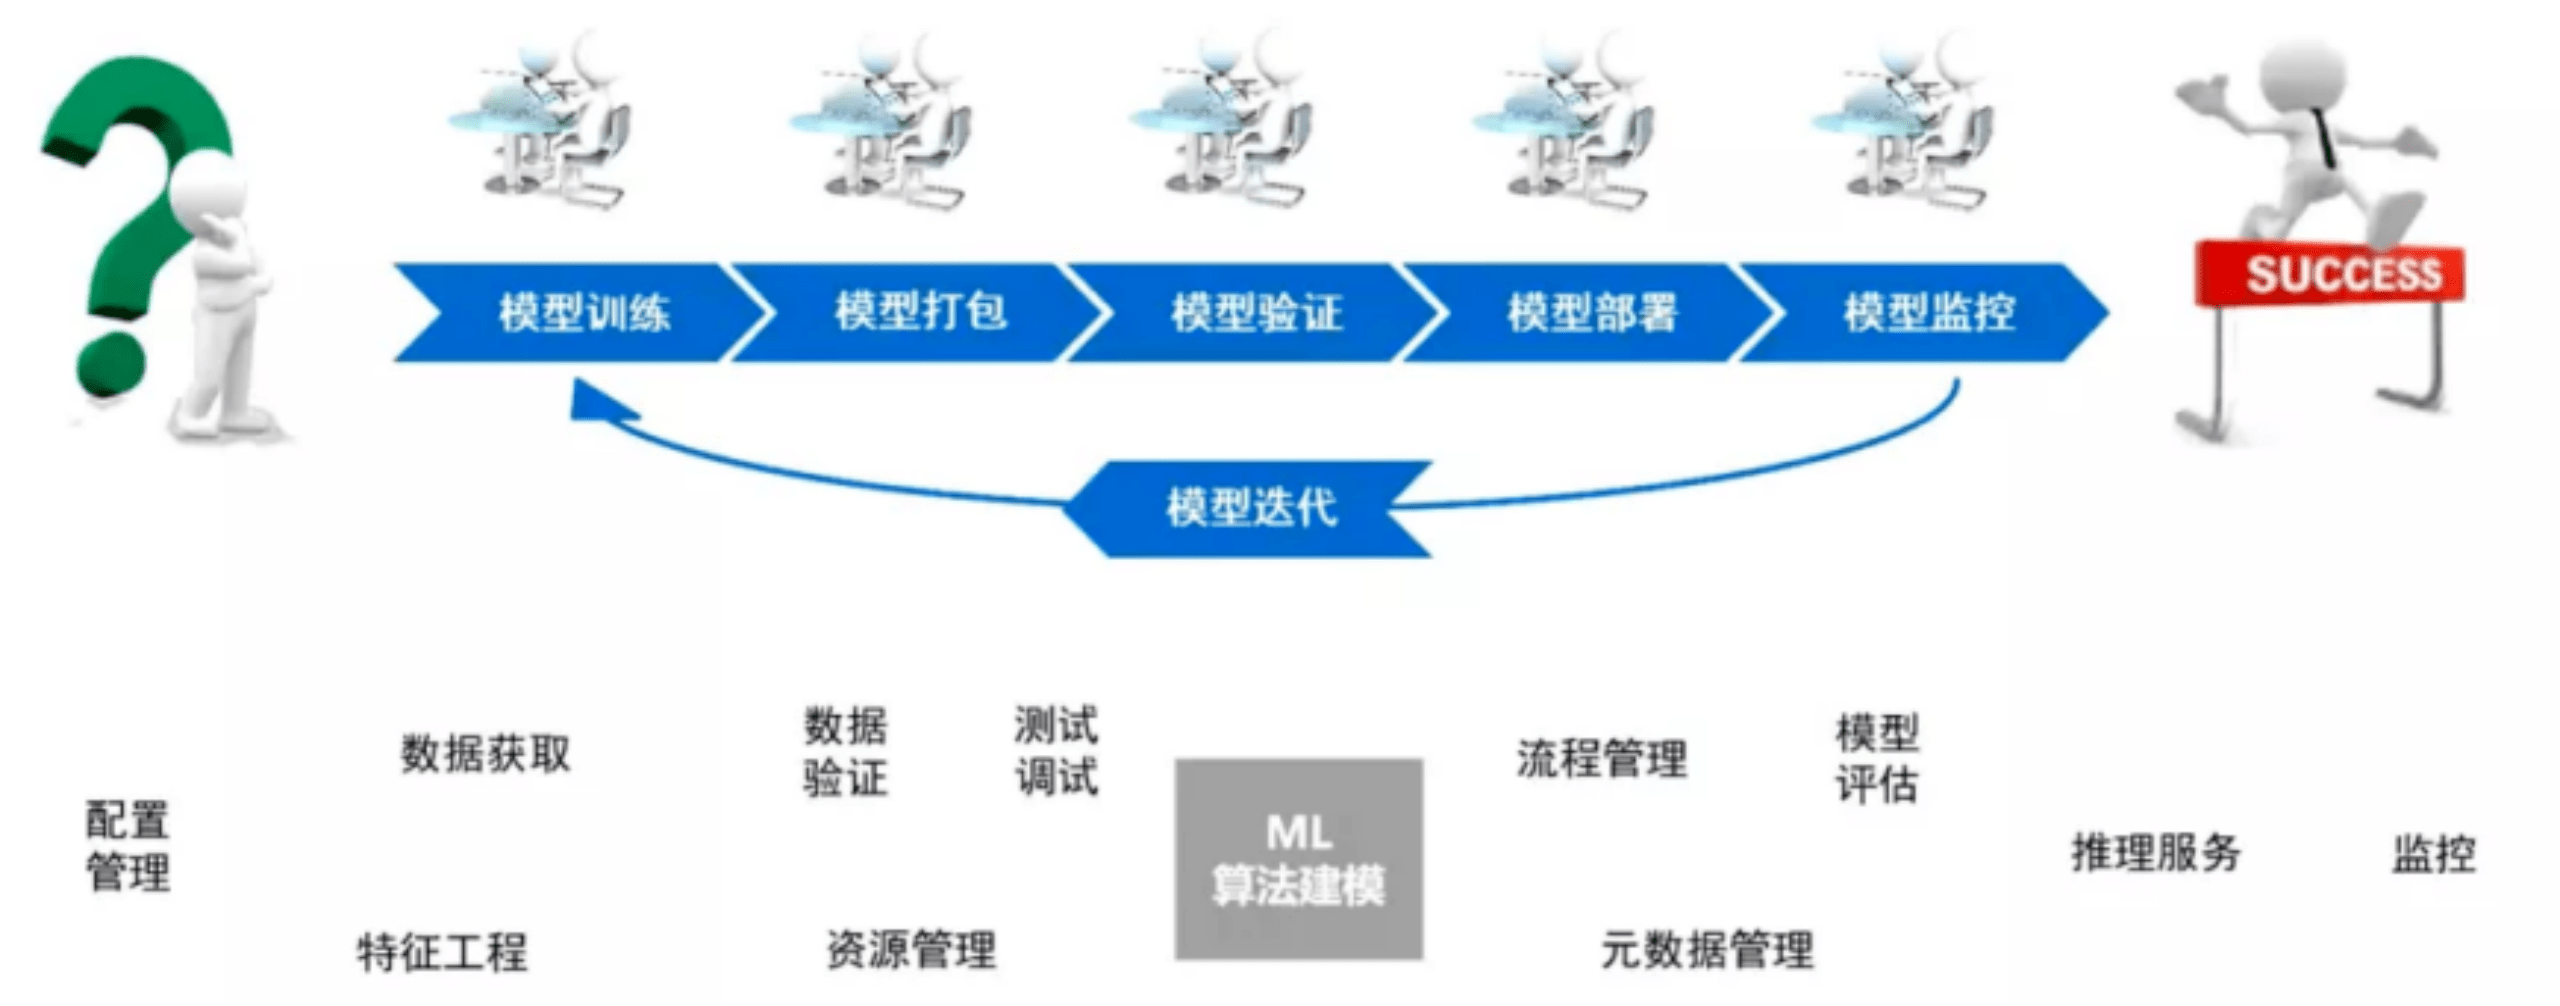
在当今这个数字化浪潮席卷全球的时代,人工智能技术的各个领域都在飞速发展。特别是在自然语言处理(NLP)方面,随着各类开源模型的不断涌现,我们正经历着前所未有的变革。这些开源模型不仅为众多开发者提供了低成本、高效率的技术工具,也为解决实际应用难题提供了新思路。
开源模型与传统模型:一场颠覆性的创新
相比于传统的封闭式人工智能系统,基于开源技术平台构建的语言模型无疑展现出了诸多优势。首先,它们可以通过社区的力量被不断地优化和更新,从而实现更精准、更智能的功能表现。其次,在资源有限的情况下,开源模型的可扩展性强,使得小团队也能够参与到这项伟大的事业中来。
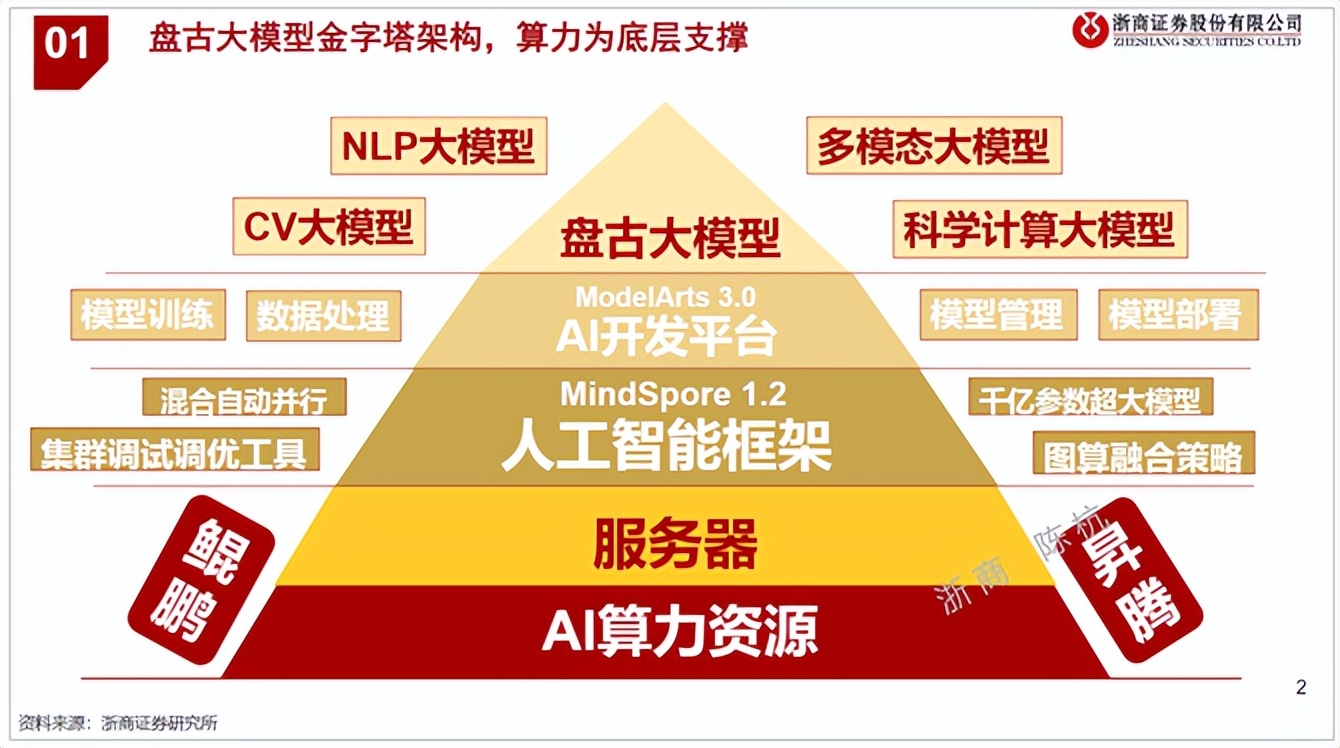
然而值得注意的是,并非所有的开源模型都具备相同的质量或适用范围。例如,一些基于深度学习框架开发出的文字生成工具虽然能够快速完成初步训练并投入使用,但在面对复杂场景时可能会出现理解偏差或者表达不自然的问题。因此,在选择合适的开源权重进行实际应用之前,需要综合考虑其背后的算法基础、数据集大小以及社区支持情况等因素。
挑战与机遇:平衡开放与保护
尽管开源模型带来了巨大的便利性,但同时也伴随着一些挑战。一方面,如何确保这些共享资源的安全性和隐私性成为了亟待解决的问题;另一方面,在促进知识传播的同时也要避免不正当竞争。例如,有些研究者可能会利用他人已训练好的优质权重来进行自己商业化的项目开发。
面对这样的情况,构建一套完善的监管机制显得尤为重要。这既包括对用户数据使用协议的严格把控,也涵盖了对于技术进步成果归属权的有效保护措施。只有当参与各方都能遵守规则时,整个生态系统才能健康可持续地发展下去。
总之,在当前这个充满活力的技术变革时期里,开源模型权重正在以前所未有的速度改变着我们与机器交互的方式。它们如同一把开启未来大门的钥匙,为我们打开了无限可能的世界。同时也要警惕潜在的风险,并通过共同努力来构建一个更加公平合理、安全可靠的AI时代。